Support 24/7: +48 61 646 07 77
Nowelizacja ustawy o krajowym systemie cyberbezpieczeństwa (uKSC) oraz dyrektywa NIS2 odbierają działom IT komfort wielodniowego, cichego diagnozowania awarii za zamkniętymi drzwiami serwerowni. Podmiot kluczowy lub ważny ma maksymalnie 24 godziny od momentu powzięcia wiedzy o incydencie poważnym na wysłanie wczesnego ostrzeżenia do właściwego zespołu CSIRT (najczęściej CSIRT NASK) przez rządowy system S46, a następnie 72 godziny na pełne zgłoszenie techniczne. Dotrzymanie tych okien czasowych przy ataku w nocy z piątku na sobotę nie zależy od sprawności prawników – wymaga scentralizowanego repozytorium logów (WORM), zsynchronizowanego czasu NTP, gotowych runbooków inżynierskich oraz dyżuru 24/7/365, który odróżni zwykłą usterkę od włamania i zabezpieczy dowody w pamięci RAM przed restartem maszyn.
Z tego artykułu dowiesz się:
Przez lata w polskich firmach technologicznych, produkcyjnych i e‑commerce obowiązywał niepisany protokół kryzysowy. Gdy w sobotę nad ranem padała baza danych albo na serwerach pojawiały się podejrzane procesy, administratorzy zamykali się na kanale komunikatora, po cichu odtwarzali środowisko z kopii zapasowych i łatali dziurę w zaporze sieciowej.
Dopiero w poniedziałek po południu, gdy produkcja znów działała stabilnie, zarząd wspólnie z prawnikami zastanawiał się, czy o zdarzeniu trzeba kogokolwiek informować.
W reżimie znowelizowanej ustawy o KSC taki model działania jest najkrótszą drogą do katastrofy regulacyjnej i wizerunkowej.
Ustawodawca zaprojektował trzystopniowy mechanizm raportowania (24h / 72h / 30 dni) z zupełnie innego powodu niż chęć karania firm za sam fakt padnięcia ofiarą cyberprzestępców. Zespoły poziomu krajowego – CSIRT NASK, CSIRT GOV oraz CSIRT MON – pełnią funkcję centralnego układu nerwowego gospodarki. Kiedy zgłaszasz im wczesne ostrzeżenie w pierwszej dobie ataku, analitycy państwowi otrzymują wzorce ruchu i adresację serwerów sterujących (C2), dzięki czemu mogą natychmiast ostrzec inne firmy z Twojego sektora, zanim ta sama kampania ransomware sparaliżuje kolejnych dostawców.
Właśnie dlatego prawo traktuje terminowe zgłoszenie jako parasol ochronny dla zarządu i zespołu IT:
Wniosek dla dyrektorów IT jest prosty. Dziś nie ukryjesz poważnego przestoju ani wycieku danych w powiązanym łańcuchu dostaw, bo Twoje API, certyfikaty i dostępność usług są nieustannie monitorowane przez systemy zewnętrznych kontrahentów.
Jedno z najczęstszych pytań, jakie słyszymy od architektów i szefów infrastruktury podczas audytów gotowości, brzmi następująco – czy zegar 24 godzin rusza w sekundzie, w której napastnik wysłał pierwszy złośliwy pakiet do naszej sieci, czy dopiero wtedy, gdy człowiek odczyta alert?
Przepisy uKSC oraz dyrektywy NIS2 posługują się precyzyjnym terminem – czas liczy się od momentu powzięcia wiedzy o wystąpieniu incydentu poważnego (awareness of the significant incident).
Z perspektywy inżynierii systemowej musimy tu wyraźnie oddzielić trzy stany operacyjne:
502 Bad Gateway na brzegu sieci. Na tym etapie nie wiesz jeszcze, czy przyczyną jest zapętlone zapytanie SQL po piątkowym wdrożeniu, awaria kości pamięci RAM, czy atak szyfrujący.Pułapka nieodebranych alertów – wielu zarządom wydaje się, że skoro zegar startuje dopiero od momentu „powzięcia wiedzy”, to wyłączenie powiadomień na weekend i odczytanie czerwonych alertów dopiero w poniedziałek o 8.00 rano legalnie przesunie start okna 24‑godzinnego. To niebezpieczna iluzja. Podczas analizy powypadkowej audytor porówna znaczniki czasu (timestamps) z logów zapory sieciowej i systemu SIEM z godziną pierwszej reakcji administratora. Jeżeli systemy bezpieczeństwa wygenerowały krytyczny alarm o włamaniu w piątek o 23.15, a przez 56 godzin nikt na niego nie spojrzał z braku dyżuru, organ nadzorczy zakwalifikuje to jako rażące naruszenie wymogu ciągłego monitorowania zagrożeń.
Nie każda usterka w serwerowni wymaga budzenia prezesa zarządu i wysyłania pilnego formularza w systemie S46. Gdyby zespoły DevOps i administratorzy zgłaszali do CSIRT NASK każdy zrestartowany kontener w Kubernetesie czy chwilowe wysycenie puli połączeń do bazy danych, państwowy system uległby paraliżowi w ciągu jednego przedpołudnia.
Ustawa nakłada obowiązek raportowania w reżimie 24h i 72h wyłącznie wtedy, gdy zdarzenie przekroczy próg incydentu poważnego.
W codziennej praktyce inżynierskiej łatwo pomylić pojęcie „cyberataku” z pojęciem „incydentu”. W świetle przepisów uKSC oraz dyrektywy NIS2 incydentem jest każde zdarzenie, które ma niekorzystny wpływ na bezpieczeństwo sieci i systemów informacyjnych – czyli na ich dostępność, autentyczność, integralność lub poufność.
Oznacza to bardzo ważną rzecz dla architektów infrastruktury.
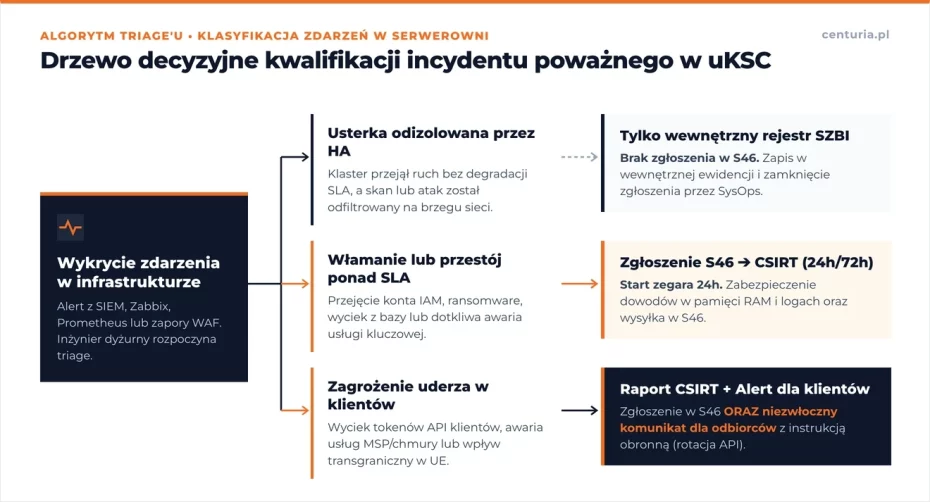
Jeżeli w Twojej serwerowni przepali się pojedynczy zasilacz redundantny (PSU) albo wypadnie jeden dysk NVMe w macierzy RAID 10, a klaster automatycznie przejmie ruch bez żadnej degradacji usługi dla klientów – to zwykłe zdarzenie eksploatacyjne, które zamykasz wewnętrznym biletem serwisowym.
Sytuacja zmienia się diametralnie w dwóch przypadkach:
Aby zespół dyżurny nie musiał w środku nocy zgadywać, czy dana sytuacja wymaga uruchomienia procedury S46, organizacja musi przełożyć przepisy na mierzalne parametry techniczne. Ustawodawca definiuje incydent poważny poprzez dwa główne filtry – dotkliwość zakłócenia operacyjnego oraz skalę strat po stronie odbiorców.
W praktyce monitoringu serwerów sprowadza się to do trzech twardych wskaźników:
Dla ułatwienia pracy inżynierów dyżurnych oraz osób kontaktowych wyznaczonych w systemie S46 zebraliśmy różnice między poszczególnymi kategoriami zdarzeń w praktycznym zestawieniu operacyjnym.
| Kategoria zdarzenia | Przykłady techniczne w infrastrukturze |
Obowiązek zgłoszenia w S46 / CSIRT |
Wymagana reakcja operacyjna |
|---|---|---|---|
| Anomalia lub incydent wewnętrzny | Awaria pojedynczego węzła w klastrze HA bez przerwy w działaniu usługi, zablokowany skan portów na firewallu, odfiltrowany atak DDoS na warstwie WAF. |
Brak obowiązku – zdarzenie odnotowywane wyłącznie w wewnętrznym rejestrze incydentów SZBI. |
Standardowa obsługa przez zespół SysOps/DevOps, analiza logów i zamknięcie ticketa. |
| Incydent poważny (uKSC / NIS2) | Skuteczny atak ransomware, przejęcie konta z uprawnieniami administracyjnymi, wyciek z bazy danych, długotrwały przestój usługi przekraczający progi ciągłości. |
Bezwzględny obowiązek – wczesne ostrzeżenie w 24h, pełne zgłoszenie w 72h, raport końcowy w 30 dni. |
Uruchomienie runbooka kryzysowego, zabezpieczenie dowodów w RAM i logach, mitygacja oraz wysyłka w S46. |
| Incydent poważny lub istotne cyberzagrożenie z wpływem na klientów | Złamanie zabezpieczeń u dostawcy SaaS/MSP/chmury, wykradzenie tokenów integracyjnych API klientów, aktywna luka zagrażająca podłączonym systemom B2B. |
Podwójny obowiązek – raport do CSIRT (24h/72h) ORAZ niezwłoczne powiadomienie odbiorców usług. |
Izolacja środowiska + wysłanie klientom instrukcji środków zaradczych (np. wymuszona rotacja kluczy i haseł). |
Największym paraliżem podczas realnego incydentu jest przekonanie zarządu oraz inżynierów, że już w pierwszym zgłoszeniu trzeba przedstawić państwu kompletny raport ze śledztwa. Zespół techniczny odkłada więc otwarcie formularza w systemie S46 z godziny na godzinę, bo „wciąż analizujemy logi i nie wiemy dokładnie, przez którą lukę weszli atakujący”.
Takie podejście mija się z konstrukcją ustawy.
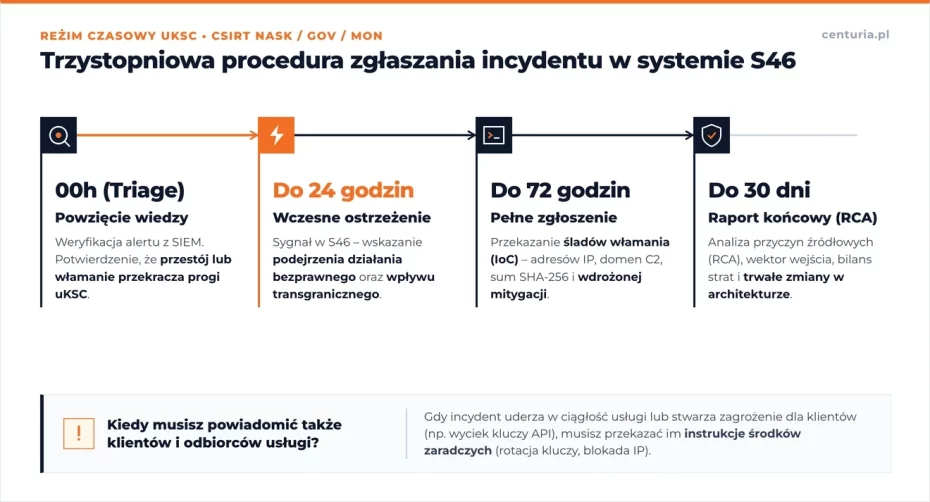
Ustawodawca doskonale zdaje sobie sprawę, że w pierwszych godzinach po wykryciu włamania lub ataku szyfrującego w serwerowni trwa walka o utrzymanie procesów biznesowych. Dlatego procedura w systemie S46 została rozbita na trzy niezależne etapy, w których stopień szczegółowości rośnie wraz z postępem prac inżynierskich.
Pierwszy komunikat wysyłany do właściwego zespołu CSIRT (CSIRT NASK, CSIRT GOV lub CSIRT MON) nie jest elaboratem powłamaniowym, lecz szybkim sygnałem alarmowym. Musisz go przesłać niezwłocznie, nie później niż w ciągu 24 godzin od momentu powzięcia wiedzy o wystąpieniu incydentu poważnego.
Na tym etapie formularz w systemie S46 wymaga od Ciebie odpowiedzi przede wszystkim na dwa kluczowe pytania:
Zasada inżynierska w pierwszej dobie brzmi jednoznacznie – nie czekaj na stuprocentową pewność i zakończenie analizy dysków.
Wpisujesz tylko te fakty, które zespół dyżurny ustalił podczas wstępnego triage’u (np. „od godziny 02.15 obserwujemy niedostępność klastra produkcyjnego wywołaną nieautoryzowanym szyfrowaniem wolumenów; trwa izolacja segmentów sieciowych”). Wysłanie wczesnego ostrzeżenia zamyka ryzyko formalnego przekroczenia terminu, a Twoim inżynierom daje kolejne dwie doby na spokojne zebranie twardych dowodów technicznych.
Gdy pierwszy pożar zostanie opanowany, masz maksymalnie 72 godziny od momentu powzięcia wiedzy o incydencie na przesłanie właściwego zgłoszenia technicznego (incident notification). Ten dokument aktualizuje informacje z wczesnego ostrzeżenia i dostarcza analitykom CSIRT konkretny materiał inżynierski.
W zgłoszeniu 72‑godzinnym musisz zawrzeć trzy grupy danych:
Ostatni etap procedury następuje nie później niż miesiąc od dnia złożenia zgłoszenia 72‑godzinnego. W tym momencie emocje już opadły, środowisko produkcyjne pracuje stabilnie, a zespół ma za sobą pełne dochodzenie techniczne.
Raport końcowy podsumowuje całe zdarzenie i musi zawierać:
Co w sytuacji, gdy incydent jest na tyle złożony, że po upływie 30 dni działania naprawcze lub śledztwo wciąż trwają? Ustawa przewiduje na taką okoliczność sprawozdanie z postępów prac (progress report), a właściwy raport końcowy składasz wówczas w terminie miesiąca od momentu całkowitego zakończenia obsługi zdarzenia.
Skupienie całej uwagi wyłącznie na formularzach wysyłanych do CSIRT NASK potrafi uśpić czujność w drugim, równie ważnym obszarze.
Znowelizowana ustawa o KSC nakłada na podmioty kluczowe i ważne obowiązek komunikacji w dół łańcucha dostaw:
Dla firm technologicznych, dostawców SaaS, operatorów chmury i software house’ów oznacza to jedno – obok technicznego runbooka dla inżynierów musisz mieć przygotowany szablon komunikatu technicznego dla działów bezpieczeństwa Twoich klientów, obsługiwany przez osoby kontaktowe wyznaczone wcześniej zgodnie z art. 58 uKSC.
Na papierze każde wdrożenie Systemu Zarządzania Bezpieczeństwem Informacji wygląda wzorowo. W segregatorze CISO leży wydrukowana polityka obsługi incydentów, schemat eskalacji oraz tabela z numerami telefonów.
Problem w tym, że grupy ransomware oraz zautomatyzowane botnety nie atakują we wtorek o godzinie 11.00, gdy cały zespół DevOps siedzi przy biurkach z otwartymi terminalami.
Z danych telemetrycznych zespołów reagowania jednoznacznie wynika, że ponad 70% niszczących ataków szyfrujących i prób wykradzenia baz danych rozpoczyna się w nocy z piątku na sobotę, w niedziele lub w dni ustawowo wolne od pracy. Intruzi celowo wybierają moment, w którym czas reakcji wewnętrznego działu IT wydłuża się z minut do kilkudziesięciu godzin.
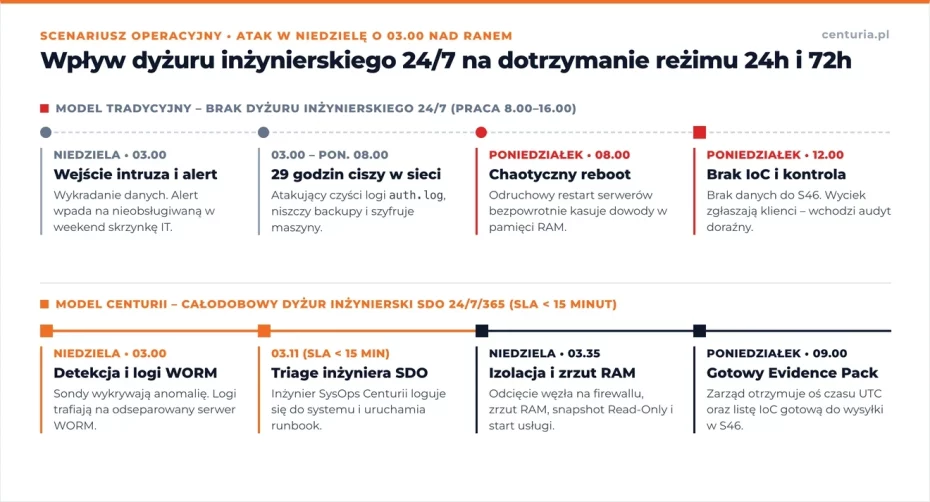
Gdy w niedzielę o 3.00 nad ranem w firmie pozbawionej profesjonalnego dyżuru zaczyna wyć alarm, dochodzi zazwyczaj do jednego z dwóch scenariuszy – albo powiadomienie wpada na skrzynkę mailową, którą ktoś otworzy dopiero w poniedziałek rano, albo wyrwany ze snu administrator podejmuje działania pod wpływem stresu. O tym, jak uniknąć chaosu organizacyjnego w takich godzinach, pisaliśmy szerzej w artykule omawiającym skuteczne zarządzanie dyżurami i linią wsparcia 24/7.
Z technicznego punktu widzenia największym wrogiem raportowania w reżimie 24h/72h jest ulotność domyślnych logów w nowoczesnych architekturach:
kubectl delete pod) – jeżeli Twoja aplikacja działa w klastrze Kubernetesa lub w kontenerach Docker bez zewnętrznego kolektora logów, wszystkie wpisy ze strumieni stdout oraz stderr żyją wyłącznie tak długo, jak sam kontener. Gdy spanikowany administrator widzi zawieszony lub zainfekowany pod i odruchowo go restartuje, w ułamku sekundy bezpowrotnie kasuje całą historię wejścia agresora.logrotate) – podczas ataku brute‑force, skanowania podatności lub masowego wyciągania danych z API serwer WWW (Nginx / Apache) oraz zapora sieciowa generują gigabajty wpisów na godzinę. Przy domyślnych ustawieniach logrotate na Linuksie stare pliki /var/log/auth.log czy access.log zostają nadpisane zanim ktokolwiek zdąży je zabezpieczyć.root lub SYSTEM, w pierwszym kroku czyści historię powłoki (history ‑c, usunięcie .bash_history) oraz wycina wpisy w lokalnym dzienniku systemd‑journald lub Windows Event Log.Kiedy w poniedziałek rano zespół próbuje wypełnić formularz 72‑godzinny dla CSIRT NASK, okazuje się, że na serwerze produkcyjnym nie ma już ani jednego śladu IoC.
Aby organizacja była w stanie odtworzyć przebieg włamania i wygenerować wiarygodny raport w ustawowym oknie czasowym, musi spełnić dwa twarde warunki architektoniczne, których nie zastąpi żaden dokument prawny.
Pierwszym z nich jest bezwzględna synchronizacja czasu systemowego (NTP / chrony) w strefie UTC na każdym elemencie infrastruktury.
Wyobraź sobie próbę korelacji ataku, w której firewall brzegowy ma zegar przesunięty o 4 minuty do przodu, węzeł roboczy Kubernetesa działa w czasie lokalnym CET, a serwer bazy danych PostgreSQL spóźnia się o 90 sekund. W takich warunkach powiązanie pojedynczego żądania HTTP z konkretnym zapytaniem SQL i wywołaniem procesu w systemie operacyjnym staje się koszmarem analitycznym, a oś czasu (timeline) przedstawiona audytorowi rozpada się przy pierwszym pytaniu kontrolnym.
Drugim warunkiem jest strumieniowanie telemetrii w czasie rzeczywistym do odseparowanego, centralnego repozytorium logów (np. w oparciu o stos OpenSearch, Graylog, Grafana Loki lub dedykowany system SIEM):
root na maszynie produkcyjnej nie może dawać intruzowi technicznej możliwości skasowania lub zmodyfikowania logów wysłanych sekundę wcześniej do centralnego kolektora.sudo, auditd) oraz zapytania DNS.W chwili wykrycia włamania naturalnym priorytetem biznesu jest jak najszybsze przywrócenie działania sklepu, platformy usługowej czy linii produkcyjnej. Z kolei wymogi uKSC oraz analiza powłamaniowa wymagają zachowania dowodów (tzw. evidence preservation).
Jak pogodzić te dwa sprzeczne cele o czwartej nad ranem bez niszczenia materiału dowodowego?
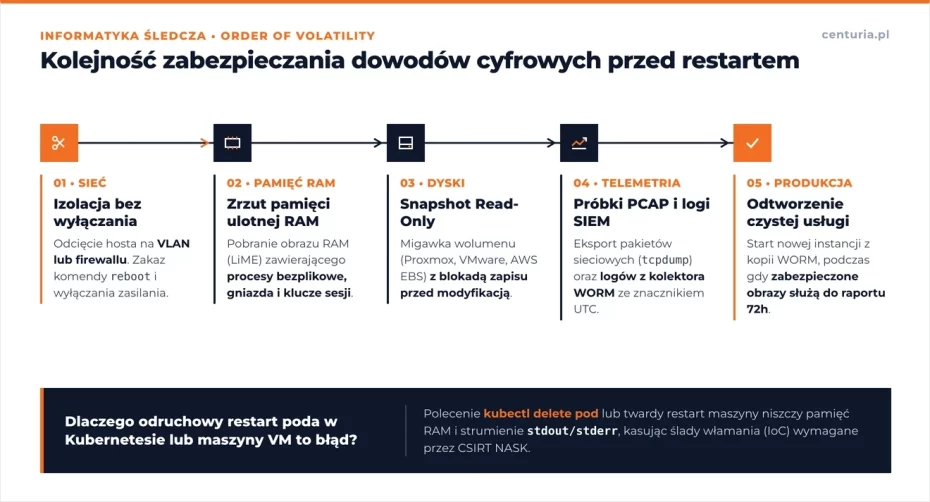
Kluczem jest przestrzeganie inżynierskiej zasady ulotności danych (order of volatility). Zanim ktokolwiek wyda komendę reboot, zaorze maszynę wirtualną i odtworzy ją z czystego backupu, dyżurny inżynier musi wykonać czteroetapową procedurę zabezpieczającą:
power off). Zamiast tego odetnij go na poziomie reguł Security Group w chmurze, wirtualnego switcha lub VLAN‑u, blokując komunikację z Internetem i resztą sieci lokalnej przy zachowaniu włączonego systemu operacyjnego.tcpdump), które pokażą analitykom CSIRT NASK, z jakimi adresami IP i domenami C2 próbował komunikować się przejęty host.Dopiero po wykonaniu tych operacji – co przy zautomatyzowanych skryptach zajmuje kilkanaście minut – możesz bezpiecznie postawić czyste instancje produkcyjne na boku, podczas gdy zabezpieczone obrazy posłużą do przygotowania precyzyjnego zgłoszenia 72‑godzinnego.
Podczas rzeczywistego ataku nikt nie ma czasu na czytanie pięćdziesięciu stron ogólnej „Polityki Zarządzania Incydentami” napisanej językiem prawniczym.
Aby zespół techniczny był w stanie zamknąć triage i wysłać wczesne ostrzeżenie w 24 godziny, potrzebuje krótkich, operacyjnych runbooków inżynierskich (Standard Operating Procedures – SOP) przypisanych do konkretnych scenariuszy (np. Runbook A – wykrycie szyfrowania ransomware, Runbook B – przejęcie klucza IAM w chmurze, Runbook C – wolumetryczny atak DDoS / RCE na aplikację webową).
Dobry runbook inżynierski mieści się na dwóch ekranach i zawiera wyłącznie twarde instrukcje wykonawcze:
Utrzymanie wewnętrznego zespołu inżynierów bezpieczeństwa i administratorów systemowych pracujących w systemie trzyzmianowym (24/7/365) wymaga zatrudnienia na wyłączność minimum pięciu lub sześciu wysokiej klasy specjalistów. Dla większości średnich i dużych przedsiębiorstw z sektorów produkcyjnych, logistycznych, handlowych czy technologicznych jest to bariera nie do przeskoczenia – zarówno budżetowo, jak i rekrutacyjnie.
Właśnie w tym miejscu wchodzi zespół Centurii, przejmując na siebie operacyjny ciężar całodobowego nadzoru nad infrastrukturą i technicznej obsługi incydentów.
Wiele firm oferujących zewnętrzne wsparcie IT sprzedaje pod hasłem „całodobowego monitoringu” zwykłą infolinię pierwszej linii (L1 Helpdesk). W takim modelu, gdy w niedzielę o 3.15 nad ranem pada klaster produkcyjny albo zapora rejestruje próbę włamania, konsultant jedynie odbiera alert i zaczyna dzwonić do Twojego dyrektora IT, budząc go w środku nocy.
W Centurii działamy w zupełnie innym standardzie inżynierskim.
Nasz całodobowy monitoring serwerów i dyżur inżynierski 24/7/365 (SDO) jest obsadzony bezpośrednio przez doświadczonych administratorów SysOps oraz inżynierów DevOps. Gdy systemy telemetryczne wykryją anomalię o dowolnej porze dnia lub nocy, dyżurny inżynier podejmuje interwencję w gwarantowanym umową SLA czasie poniżej 15 minut – samodzielnie logując się do środowiska i rozpoczynając techniczny triage bez czekania na pobudkę Twojego zespołu.
Zanim zaczniemy chronić Twoją infrastrukturę, porządkujemy jej architekturę obserwowalności (observability). Konfigurujemy spójną synchronizację czasu NTP, wdrażamy odseparowane, niezmienne repozytoria logów oraz ustawiamy wielowarstwowe sondy monitorujące:
auditd, sudo), kontrola integralności kluczowych plików konfiguracyjnych, monitorowanie podejrzanych procesów w klastrach Kubernetes i środowiskach wirtualnych (Proxmox, VMware, AWS, Azure).Dzięki temu nasz inżynier dyżurny jest w stanie odciąć przejęty węzeł lub zablokować wektor ataku w pierwszych kilkunastu minutach od wystąpienia anomalii – często zanim złośliwy skrypt zdąży zaszyfrować pierwszy wolumen produkcyjny.
Co najważniejsze z punktu widzenia zarządu oraz osoby kontaktowej wpisanej do systemu S46 – nie zostawiamy Cię samego z pustym formularzem rządowym.
Podczas gdy nasi inżynierowie izolują zagrożenie i odtwarzają ciągłość działania usługi, równolegle zabezpieczamy materiał dowodowy zgodnie z zasadami informatyki śledczej (zrzuty pamięci RAM, migawki dysków read‑only, próbki ruchu PCAP). Na tej podstawie przygotowujemy dla Twojej organizacji gotowy wsad techniczny (evidence pack), który zawiera:
Twój zarząd oraz dział prawny otrzymują na biurko wyselekcjonowane, twarde dane techniczne, które wystarczy podpisać kwalifikowanym podpisem elektronicznym i wysłać w systemie S46 – bez nerwowego szukania logów i bez ryzyka przekroczenia ustawowych terminów.
Ustawowe okno 24 godzin na zgłoszenie wczesnego ostrzeżenia do CSIRT NASK oraz 72 godzin na pełną notyfikację incydentu to brutalny sprawdzian dojrzałości technicznej dla każdej organizacji objętej nowelizacją uKSC. W zderzeniu z nocnym atakiem ransomware lub włamaniem do chmury wygrywają nie te firmy, które posiadają najgrubsze segregatory z politykami bezpieczeństwa, lecz te, które dysponują niezmiennymi logami, przetestowanymi runbookami i żywym inżynierem na dyżurze.
Zamiast ryzykować utratę dowodów cyfrowych i paraliż decyzyjny w środku weekendu, powierz nadzór nad swoją infrastrukturą zespołowi, który od lat utrzymuje systemy o krytycznym znaczeniu biznesowym.
Sprawdź, jak wygląda audyt gotowości i monitoring serwerów pod NIS2 w wykonaniu certyfikowanych inżynierów Centurii (ISO/IEC 27001, AWS Certified Security, CKA Kubernetes) – od wdrożenia centralnych repozytoriów logów WORM i konfiguracji zapór WAF, przez opracowanie technicznych runbooków, aż po całodobowy dyżur SDO 24/7/365 z gwarancją reakcji poniżej 15 minut.